 Kişisel Blog
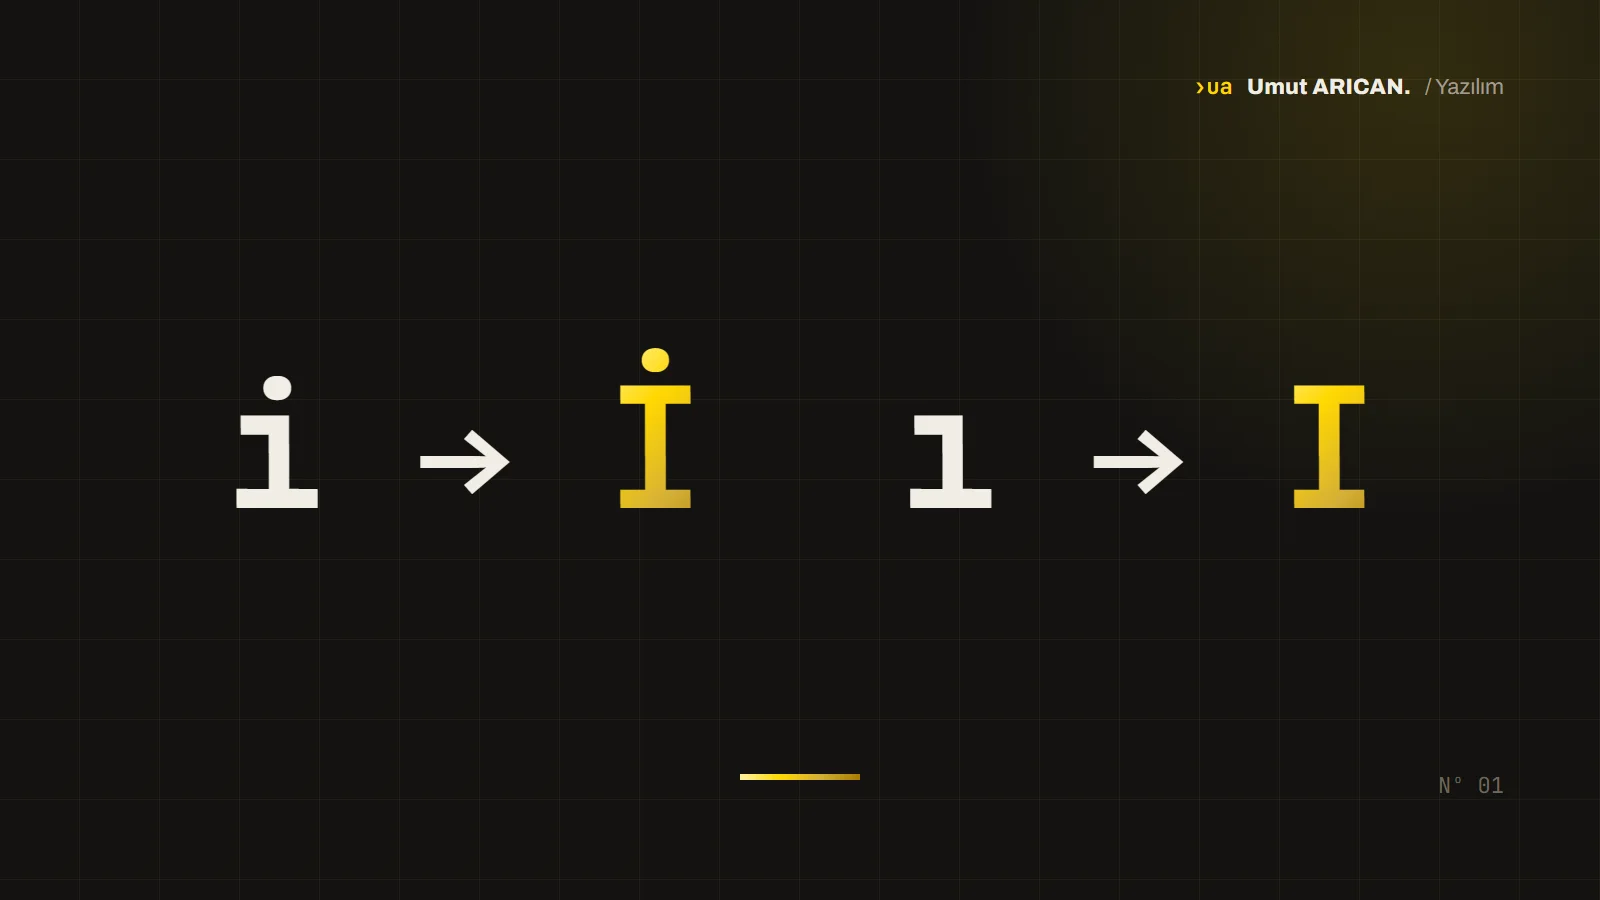
Türkçe yazılım geliştiren herkesin bir gün karşılaştığı bir hata var: kullanıcı adı "istanbul" yazıyor, ekranda "ISTANBUL" görünüyor. Ya da arama kutusuna "ILIK" yazılıyor, veritabanındaki "ılık" bulunamıyor. Sebep, Türkçenin noktalı ve noktasız i harflerinin büyük-küçük eşleşmesinin diğer dillerden farklı olması.
Bu blogun arama özelliğini yazarken aynı sorunla bir kez daha karşılaştım. Aşağıdaki çıktıların hepsi PHP 8.4'te çalıştırılarak alındı.
Sorun: dört harf, iki farklı kural
İngilizcede i'nin büyüğü I'dır. Türkçede ise iki ayrı çift var:
i↔İ(noktalı)ı↔I(noktasız)
PHP'nin dönüşüm fonksiyonları dil bilgisi olmadan çalıştığı için varsayılan olarak İngilizce kuralı uyguluyor.

strtoupper: hiç denemeyin
var_dump(strtoupper("istanbul ılık iğdır"));
// string(23) "ISTANBUL ıLıK IğDıR"
strtoupper bayt bazında çalışır ve UTF-8'i bilmez. Sadece ASCII harfleri dönüştürür, ı ve ğ olduğu gibi kalır. Türkçe metinde kullanılmaması gerekiyor.
mb_strtoupper: neredeyse doğru
var_dump(mb_strtoupper("istanbul ılık iğdır", 'UTF-8'));
// string(20) "ISTANBUL ILIK IĞDIR"
Çok baytlı karakterleri tanıyor, ğ ve ı doğru dönüşüyor. Ama i yine I oluyor. "İstanbul" "Istanbul"a dönüşüyor. Ters yönde durum daha da ilginç:
var_dump(mb_strtolower("İSTANBUL ILIK", 'UTF-8'));
// string(15) "i̇stanbul ilik"
Çıktıda iki hata var. I harfi ı yerine i olmuş. Daha sinsi olanı ise ilk harf: İ, Unicode kurallarına göre i + "birleşen nokta" (U+0307) olarak küçültülmüş. Ekranda normal görünüyor, ama bu metin veritabanındaki "istanbul" ile eşleşmiyor. Bayt sayısının 15 olması da bundan.
ucfirst ve başlık biçimi
var_dump(mb_ucfirst("istanbul"));                              // "Istanbul"
var_dump(mb_convert_case("istanbul ılık", MB_CASE_TITLE, 'UTF-8')); // "Istanbul Ilık"
PHP 8.4 ile gelen mb_ucfirst da aynı sorunu taşıyor.
Çözüm: intl Transliterator
PHP'nin intl eklentisi, ICU kütüphanesinin dile özel dönüşüm kurallarını kullanabiliyor. Hosting sağlayıcıların neredeyse hepsinde kurulu geliyor.
$upper = Transliterator::create('tr-Upper');
$lower = Transliterator::create('tr-Lower');
$title = Transliterator::create('tr-Title');

$upper->transliterate("istanbul ILIK İzmir"); // "İSTANBUL ILIK İZMİR"
$lower->transliterate("istanbul ILIK İzmir"); // "istanbul ılık izmir"
$title->transliterate("istanbul ILIK İzmir"); // "İstanbul Ilık İzmir"
Üç sonuç da doğru. Transliterator nesnesini oluşturmak görece maliyetli olduğu için bir kez oluşturup tekrar kullanmak gerekiyor. Ben küçük bir yardımcı sınıfta tutuyorum:
final class Tr
{
    private static array $t = [];

    public static function upper(string $s): string { return self::t('tr-Upper')->transliterate($s); }
    public static function lower(string $s): string { return self::t('tr-Lower')->transliterate($s); }
    public static function title(string $s): string { return self::t('tr-Title')->transliterate($s); }

    public static function ucfirst(string $s): string
    {
        return self::upper(mb_substr($s, 0, 1)) . mb_substr($s, 1);
    }

    private static function t(string $id): Transliterator
    {
        return self::$t[$id] ??= Transliterator::create($id);
    }
}
intl yoksa: harita yöntemi
Sunucuda intl eklentisi yoksa, sorunlu harfleri önce elle değiştirip geri kalanı mb_ fonksiyonlarına bırakmak işe yarıyor:
function tr_upper(string $s): string
{
    return mb_strtoupper(str_replace(['i', 'ı'], ['İ', 'I'], $s), 'UTF-8');
}

function tr_lower(string $s): string
{
    return mb_strtolower(str_replace(['İ', 'I'], ['i', 'ı'], $s), 'UTF-8');
}
Sıra önemli: str_replace mutlaka mb_ dönüşümünden önce çalışmalı.
Arama yaparken: veritabanı tarafı
Büyük-küçük harf duyarsız arama yaparken dönüşümü PHP'de yapmak yetmiyor; karşılaştırma veritabanında yapılıyor.
- MySQL: Sütunun collation değeri
utf8mb4_turkish_ci(MySQL 8'deutf8mb4_tr_0900_ai_ci) iseLIKE '%ılık%'sorgusu "ILIK" yazan kaydı da bulur.utf8mb4_unicode_ciiseıilei'yi farklı,Iilei'yi aynı harf sayar. - SQLite:
LIKEyalnızca ASCII harflerde büyük-küçük harf duyarsız. Bu blogun yerel geliştirme ortamında SQLite kullandığım için arama terimini yukarıdaki harita yöntemiyle küçük harfli, tamamı büyük ve ilk harfi büyük biçimlere çevirip bunlarıORile arıyorum. Böylece arama, veritabanının karşılaştırma kuralından bağımsız çalışıyor. Basit ama gayet iyi iş görüyor.
JavaScript tarafı
Tarayıcıda iş daha kolay; dil parametresi vermek yeterli:
"istanbul".toLocaleUpperCase('tr-TR'); // "İSTANBUL"
"ILIK".toLocaleLowerCase('tr-TR');     // "ılık"
"istanbul".toUpperCase();              // "ISTANBUL"  ← dil vermezseniz
Son bir uyarı: Laravel'deki Str::upper, Str::title gibi yardımcılar da içeride mb_ fonksiyonlarını kullanıyor. Kullanıcıya görünen Türkçe metinlerde bu yardımcılar yerine yukarıdaki gibi dile duyarlı bir fonksiyon kullanmak gerekiyor.